上周那场让数亿用户失联12小时的Microsoft 365全球宕机,终于有了官方解释。
微软高管Charles Lamanna发布的初步事件后报告(PIR)揭示了一个令人不安的事实:这不是一次突发事故,而是三个独立问题在特定时刻碰撞产生的“完美风暴”。一个7月引入的软件缺陷、一次正常的Teams流量故障转移、以及前一天无关问题导致的14%容量损失——三者叠加,触发了隐藏的锁争用Bug,并在自动恢复机制的反噬下,在不到两小时内瘫痪了80%的网络网关服务器。
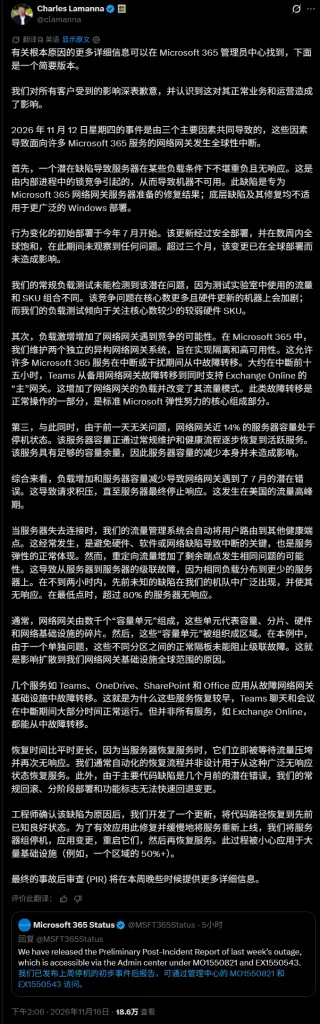
更值得深思的是:这个Bug通过了微软的所有常规测试,因为测试环境的硬件比生产环境“弱”。
1. 三重碰撞:级联故障的形成路径
| 时间线 | 事件 | 影响 |
|---|---|---|
| 2026年7月 | 网络网关服务器修复更新部署,引入锁争用Bug | 潜伏数月未被触发 |
| 宕机前1天 | 无关问题导致14%网关容量不可用 | 剩余86%仍可承载正常负载 |
| 宕机前数小时 | Teams流量从备用网关故障转移到主网关 | Exchange Online主网关负载增加、流量模式改变 |
| 宕机开始 | 增加的负载+减少的容量触发锁争用Bug | 部分服务器无响应 |
| <2小时 | 自动重定向将流量导向健康服务器 → 健康服务器过载触发同一Bug → 级联崩溃 | 80%网关瘫痪 |
关键洞察:任何一个单独的问题都不会导致全局中断。14%容量损失在冗余设计内;流量转移是正常故障转移;锁争用Bug在低负载下不触发。只有三者同时存在时,系统才越过临界点。
2. 根因:为什么测试没抓住这个Bug?
这是本次事件最值得所有技术团队反思的部分。
Bug本质:7月更新在网络网关服务器的内部进程中引入了锁争用(lock contention)。在高并发、高核心数CPU的服务器上,该锁成为瓶颈,导致进程无响应。
测试盲区:
- 测试环境使用较旧、功能较弱、CPU核心数较少的硬件
- 锁争用在低核心数/低并发下不显现或表现轻微
- 生产环境的新一代高核服务器恰好满足了Bug的触发条件
⚠️ 核心教训:测试环境的“代表性”比“覆盖率”更重要。当测试硬件与生产硬件存在代际差异时,性能相关Bug(尤其是并发、锁、缓存一致性类)极易逃逸。这不是测试用例的问题,是测试基础设施的问题。
3. 恢复困境:为什么自动机制反而加剧了崩溃?
微软的基础设施设计了自动故障转移:当服务器无响应时,流量被重定向到健康节点。这在单点故障时有效,但在系统性Bug触发场景下变成了加速器:
服务器A触发Bug → 无响应 → 流量重定向到B/C/D
→ B/C/D负载激增 → 触发同一Bug → 无响应
→ 流量重定向到E/F/G/H → ...
→ 80%网关在<2小时内级联瘫痪更糟的是:通常用于遏制级联故障的容量分区和区域隔离机制也失效了(PIR提到“另一个问题阻止了这些保障措施”),导致故障在全球范围蔓延。
恢复同样艰难:
- 工程师将服务器重新上线 → 累积流量立即压倒 → 再次崩溃
- 常规恢复机制未设计用于处理此规模故障
- 回滚7月更新不可行(已部署数月,依赖关系复杂)
- 最终方案:开发新更新将代码路径恢复到之前状态 → 分批离线 → 应用修复 → 逐步恢复
4. 服务差异化:为什么Exchange挂了但Teams活了?
| 服务 | 是否受影响 | 原因 |
|---|---|---|
| Exchange Online | ❌ 严重中断 | 无法使用替代故障转移机制,强依赖受影响网关 |
| Teams | ✅ 部分恢复 | 能够离开受影响网关基础设施 |
| OneDrive / SharePoint / Office Apps | ✅ 部分恢复 | 同上 |
这暴露了服务间韧性不一致的问题。同一基础设施上的不同服务,因架构耦合度差异,在故障中表现出截然不同的生存能力。Exchange Online作为最核心的邮件服务,反而成了最脆弱的一环。
5. 给所有技术团队的行动清单
| 优先级 | 行动项 | 适用对象 |
|---|---|---|
| 🔴 高 | 审计测试环境与生产环境的硬件代际差异,尤其是CPU核心数、内存带宽、存储IOPS | SRE/平台工程 |
| 🔴 高 | 对关键路径进行高并发/高负载压力测试,模拟生产峰值而非平均负载 | QA/性能工程 |
| 🔴 高 | 审查自动故障转移机制在系统性故障下的行为,增加级联熔断逻辑 | 架构师 |
| 🟡 中 | 建立容量分区和隔离机制的有效性验证(定期演练) | SRE |
| 🟡 中 | 评估核心服务的故障转移独立性,避免单点基础设施绑定 | 服务Owner |
| 🟢 低 | 建立“长期潜伏Bug”的检测机制(如生产环境金丝雀+异常指标监控) | 可观测性团队 |
6. 超越技术:组织层面的反思
这次事件还揭示了几个非技术问题:
- 变更的风险窗口不止于部署期:7月的更新在部署时无异常,数月后才在特定条件下触发。变更的风险评估需要覆盖“全生命周期条件组合”,而非仅部署时刻。
- “正常操作”可以是灾难触发器:Teams流量转移是标准故障转移流程,本身无错。但当系统处于隐性脆弱状态时,正常操作就是压垮骆驼的最后一根稻草。
- 恢复能力需要专门设计:常规恢复机制针对“常见故障”优化,对“罕见系统性故障”可能无效甚至有害。需要为“黑天鹅恢复”预留手动干预通道和降级预案。
微软Outlook全球宕机提醒我们:在云时代,测试环境的硬件代表性、自动恢复机制的级联安全性、以及服务间的韧性一致性,是和代码质量同等重要的基础设施属性。当一个7月的Bug能在11月摧毁80%的网关时,说明我们的安全网在某个维度上早已破了洞,只是还没遇到那阵特定的风。
微软承诺本周发布最终PIR。但比等待报告更重要的是:每个技术团队都该问自己一句——我们的测试环境,真的代表生产吗?